
Contrôle des robots d’IA : voyez ce qu’ils prennent, puis décidez
Des robots d’IA lisent votre site pour entraîner un modèle, alimenter les réponses d’un assistant ou servir un utilisateur. Votre serveur les sert tous, et vous ne savez pas combien ils pèsent. Klacos les range dans une catégorie à part, vérifie ceux qui se déclarent, vous montre leur part de votre trafic, puis applique votre choix : les laisser passer, les ralentir ou les bloquer.
Des lecteurs que vous payez sans les connaître
Les robots d’IA demandent des pages comme n’importe quel visiteur, et votre serveur les sert au même prix. Certains reparcourent votre catalogue ou vos archives à intervalles réguliers sans jamais vous renvoyer personne. D’autres vous citent dans les réponses d’un assistant et vous amènent des lecteurs. Dans vos journaux, ils se mêlent aux moteurs de recherche et aux aspirateurs qui empruntent leur nom.
Sans mesure, les deux réflexes coûtent cher. Tout bloquer vous retire des réponses où un assistant aurait pu vous citer. Tout laisser passer cède vos contenus et votre bande passante, y compris à ceux qui se font passer pour un robot connu.
Le sujet ne peut plus attendre : chaque éditeur d’assistant a désormais plusieurs robots, un par usage, et un fichier robots.txt posé une fois ne dit pas qui passe vraiment. Le guide pour bloquer les robots d’IA usage par usage détaille chaque robot et ce qu’un refus change chez son éditeur. Cette page montre comment reprendre la main sur votre site.
Comprendre d’abord, gouverner ensuite
Bloquer les robots d’IA n’a rien de nouveau. Ce qui change avec Klacos, c’est l’ordre : vous voyez ce qu’ils font sur votre site avant de choisir, et votre choix s’applique ensuite à tous, y compris à ceux qui ignorent votre robots.txt.
Une catégorie à part
Observés par défaut
Quatre réponses
Ralentir sans fermer
Vérifiés à la source
Usurpateurs repérés
Les muets jugés sur leur visite
La question dès le départ
Leur part de votre trafic, avant de trancher
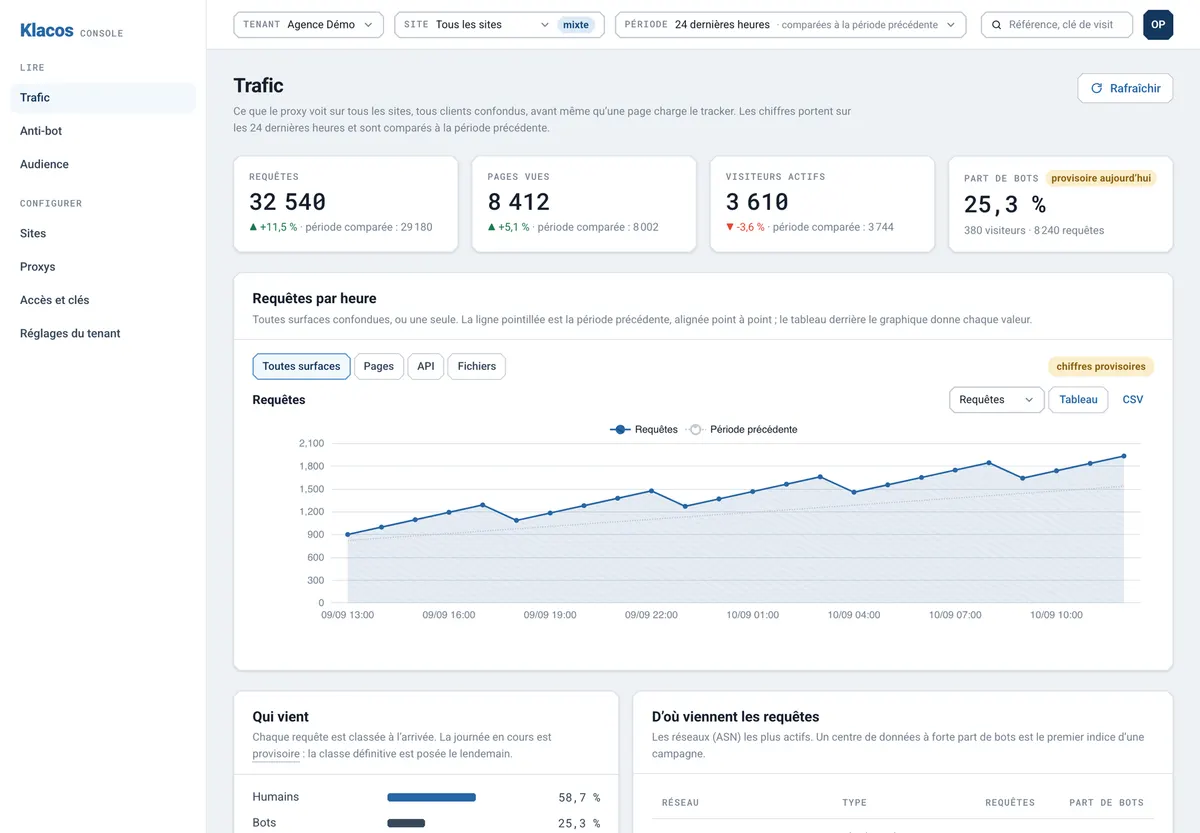
Par défaut, les robots d’IA sont observés : ils passent, et l’espace Trafic de la console montre ce que leur catégorie a demandé, en requêtes et en visiteurs, à côté des moteurs de recherche et de votre audience humaine. Côté audience, les visites que les assistants vous envoient apparaissent dans vos sources. Vous mettez en regard ce que les robots prennent et ce qu’ils rapportent.
Avant d’appliquer un réglage, vous le rejouez sur votre trafic passé pour voir ce qu’il aurait touché. Tant que vous observez, la console montre ce que votre choix aurait fait, sans rien appliquer. Vous passez ensuite au ralentissement ou au blocage un palier à la fois, avec un retour arrière en un geste.
Un nom ne suffit jamais à ouvrir la porte
N’importe quel script peut écrire « GPTBot » dans ses requêtes. Les robots d’OpenAI sont donc vérifiés sur les adresses que l’éditeur publie, comme le sont tous les robots vérifiés, et un client qui emprunte leur nom sans venir de chez lui est traité en usurpateur. Pour les autres robots d’IA, le nom déclaré peut les ranger dans la catégorie, jamais leur ouvrir une porte.
Reste le robot qui se présente comme un navigateur. Aucune ligne de robots.txt ne le vise. Celui-là est jugé sur sa visite dans son ensemble, comme n’importe quel visiteur, par la gestion des robots. S’il se comporte en robot, il est traité en robot, quel que soit le nom qu’il donne.
Votre ligne éditoriale, appliquée aux robots d’IA
Vous savez quelle part de votre trafic vient des robots d’IA, et votre choix ne dépend plus de leur bonne volonté. Votre audience ne compte que des humains, et les lecteurs que les assistants vous envoient restent visibles dans vos sources. Les moteurs de recherche gardent leur propre réglage : fermer la porte aux robots d’IA ne vous retire pas de Google Search ni des autres moteurs.
Le réglage vaut pour toute la catégorie, site par site. Pour viser un robot en particulier, votre robots.txt reste l’endroit où le nommer ; Klacos fait respecter le choix de la catégorie à ceux qui ne le lisent pas.
Pour un éditeur de presse, ce réglage s’ajoute au reste de ce que le service change : la protection des contenus d’un média en fait le tour. Le contrôle des robots d’IA fait partie de la protection de votre site.
Questions sur le contrôle des robots d’IA
Bloquer les robots d’IA me retire-t-il des moteurs de recherche ?
Non. Les moteurs de recherche forment une catégorie distincte, vérifiée à part, avec son propre réglage.
Puis-je laisser passer un robot d’IA et en bloquer un autre ?
Le réglage porte sur toute la catégorie, site par site. Pour viser un robot en particulier, nommez-le dans votre robots.txt : les grands éditeurs donnent un nom à chacun de leurs usages, et leurs robots d’exploration lisent ce fichier.
Mon fichier robots.txt ne suffit-il pas ?
C’est une demande que les robots polis respectent. Les robots qui lisent une page pour un utilisateur passent souvent outre, et un script peut emprunter n’importe quel nom. Klacos applique le choix de la catégorie à ceux qui ignorent le fichier, et juge sur leur visite ceux qui ne se déclarent pas.
Comment savoir si un robot d’IA est bien celui qu’il dit être ?
Les robots d’OpenAI sont vérifiés sur les adresses que l’éditeur publie : un client qui annonce leur nom depuis une autre adresse est traité en usurpateur. Pour les autres, le nom déclaré ne vaut pas preuve et ne leur ouvre aucune porte.
Que se passe-t-il à la création de mon site ?
La console vous demande ce que vous voulez faire des robots d’IA. Le réglage proposé est l’observation : ils passent, et vous voyez leur part de votre trafic avant de choisir.
Voyez quels robots d’IA vous lisent avant de décider de leur sort
Demandez un accès anticipé : votre site commence en observation, et la part des robots d’IA s’affiche avant que vous ne régliez quoi que ce soit. Ou parlons de vos contenus et des robots que vous voyez passer.